ラクタノ AI編集部
AIを活用して毎日最新情報をお届けしています
1. この論文を一言で言うと
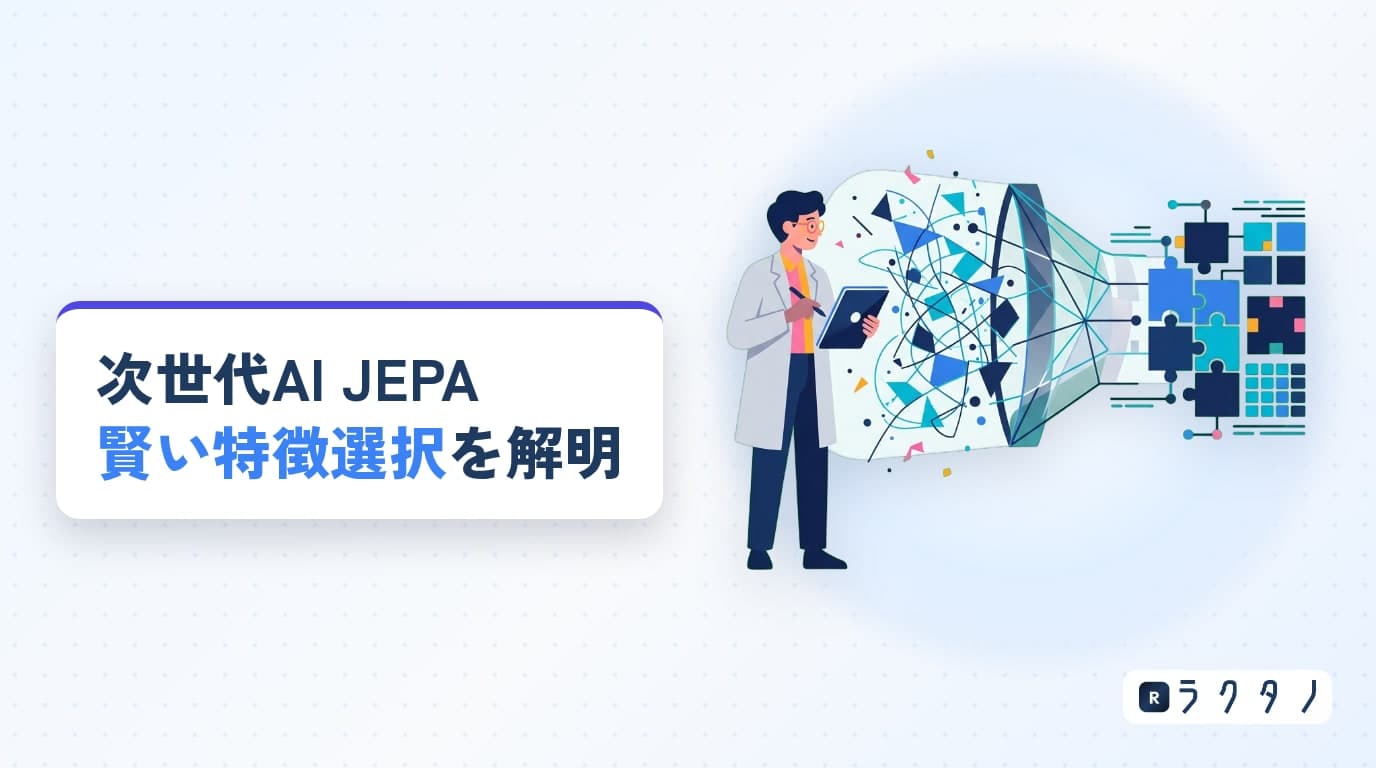
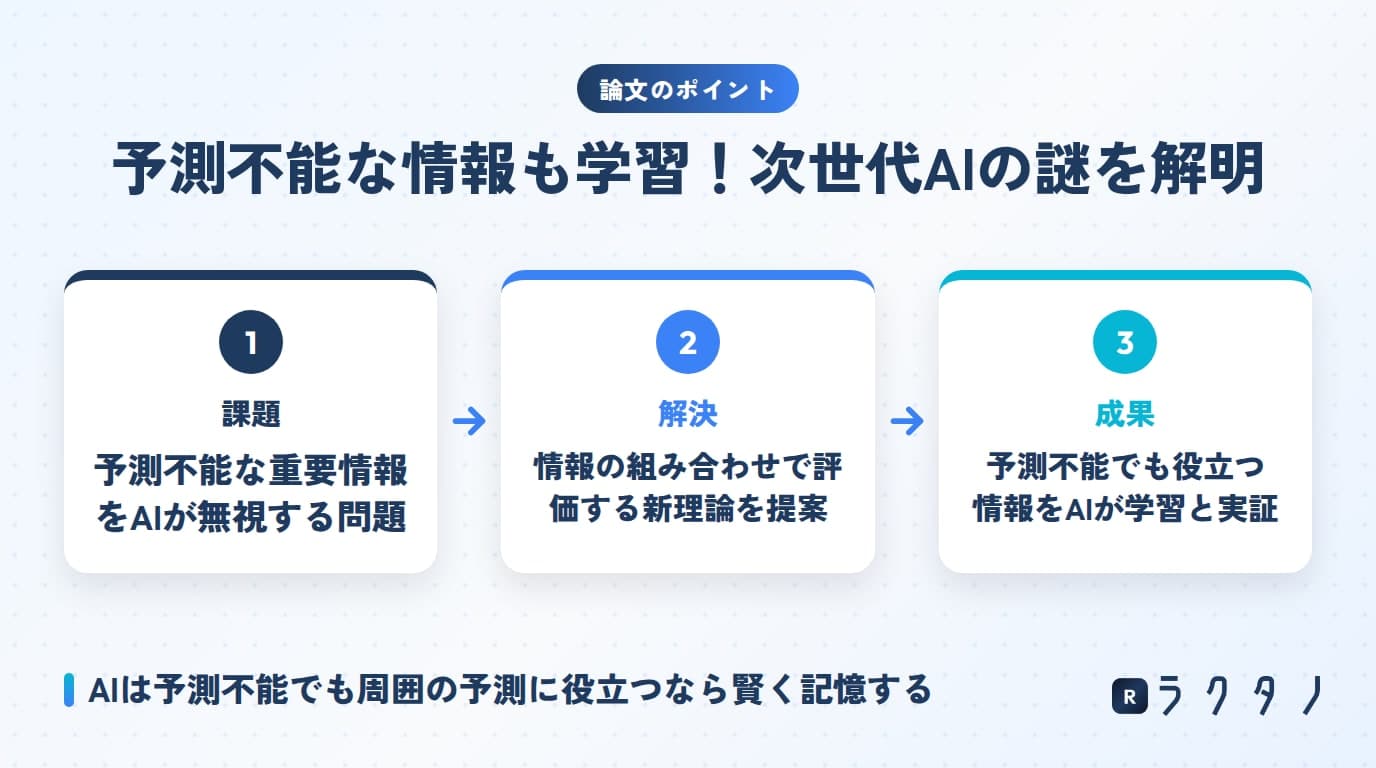
次世代AIモデルとして注目される「JEPA」が、信号機の色のように「それ単体では予測不可能な情報」であっても、周囲の状況予測に役立つのであれば自動的に学習するというメカニズムを発見した研究です。
これまでAIは、ランダムで不規則な情報を「ノイズ」として無視してしまうと考えられていましたが、実は「文脈(情報のセット)」を考慮して賢く情報を取捨選択していることが明らかになりました。この発見は、AIが現実世界の複雑な状況をより深く理解し、効率的に学習するための極めて重要な一歩となります。
2. なぜ今この研究が重要なのか
AIが現実世界を理解する「世界モデル」への期待
現在、AI業界ではテキストを生成するだけでなく、現実世界の物理法則や状況の変化を理解し、未来を予測する「世界モデル(World Model)」の構築に大きな注目が集まっています。世界モデルが完成すれば、自動運転車が歩行者の急な飛び出しを予測したり、工場のロボットが未経験のトラブルに臨機応変に対応したりすることが可能になります。
その世界モデルを実現するための有力な技術として、Meta社のチーフAIサイエンティストであるヤン・ルカン氏が提唱する「JEPA(Joint Embedding Predictive Architecture)」という次世代AIアーキテクチャがあります。JEPAは、画像や動画のピクセル(画素)をすべて完全に予測するのではなく、「重要な特徴だけを抽出して未来を予測する」という、人間の脳に近い効率的な処理を行うことで知られています。
AIは「何を捨てて、何を残すのか」という謎
しかし、JEPAには長年の大きな謎がありました。それは、膨大な映像データの中から「AIが何を基準に重要な情報を残し、無駄な情報を捨てているのか(特徴選択の基準)」が完全には解明されていなかったことです。
特に現実世界には、「次に何色に変わるかわからない信号機」や「風で不規則に揺れる木の葉」など、ランダムで予測不可能な情報があふれています。これまでの常識では、AIはこうした予測しにくい情報を「ノイズ」とみなし、学習対象から除外(無視)してしまうと考えられていました。
自動運転やロボット制御など、複雑で予測不可能な現実世界でAIを動かすニーズが急速に高まる中、AIが「本当に必要な情報」をどのように選んでいるかを解明することは、安全で効率的なシステムを設計するために避けて通れない課題となっていました。本研究は、まさにこのブラックボックスに光を当てた画期的な成果なのです。
3. 技術的に何が新しいのか
従来のアプローチ:「単体で予測しやすいか」で判断
従来のAI研究では、AIが特定の情報を学習するかどうかは、その情報が「単体で予測しやすいかどうか」に依存していると考えられていました。つまり、規則的に動く振り子のような「予測しやすい情報」は学習しやすく、ランダムに変わる信号機のような「予測しにくい情報」は学習されにくい、というシンプルな理屈です。
新概念「Predictive Closure(予測的閉包)」の発見
本研究の最大のブレイクスルーは、「Predictive Closure(予測的閉包)」という新しい概念を数学的・実験的に証明したことです。これは、AIが情報を単体で評価するのではなく、「情報のセット(組み合わせ)」で評価しているという発見です。
わかりやすい例で考えてみましょう。
交差点の映像をAIに見せたとします。「信号機の色」自体は、いつ変わるか正確にはわからないため、単体では予測不可能な情報です。しかし、その交差点には「自転車」が走っています。自転車が止まるか進むか(自転車の動き)を予測するためには、「信号機の色」という情報が絶対に欠かせません。
本研究は、JEPAがこのような状況において「信号機の色自体は予測できなくても、自転車の動きを予測するのに役立つ(セットにすると全体の予測精度が上がる)なら、信号機の情報もあえて記憶する」ということを明らかにしました。AIは私たちが思っていた以上に、周囲の文脈を読んで賢く情報を拾い上げていたのです。
AIの学習をコントロールする「ステアリング(操縦)」
さらに実験では、このメカニズムを逆手に取った興味深い技術も確認されました。それがAIの学習を間接的に誘導する「ステアリング(操縦)」です。
例えば、「風の強さ」と「旗の揺れ」という2つの情報があるとします。AIに「風の強さ」という特定の情報を補助的に教え込む(強調する)設定にすると、AIはそれを予測するために、関連する「旗の揺れ」という別の情報までしっかりと学習するようになりました。
つまり、人間が直接教えなくても、関連するヒントを与えるだけで、AIが自律的に周囲の重要な情報を芋づる式に学習するようコントロールできることが証明されたのです。
4. 実社会・ビジネスへのインパクト
この研究成果は、決して研究室の中だけの話ではありません。現実の動的な環境(常に変化する環境)を扱う多くのビジネス領域に、今後数年で多大な影響を与えると考えられます。
製造業における異常検知の高度化
例えば、工場の製造ラインにおける異常検知AIの開発を想定してください。工場内には、ランダムに動き回る作業員や、不規則な機械の振動(ノイズ)など、一見すると予測不可能なデータがあふれています。
従来であれば、これらは「AIの学習を妨げるノイズ」として処理されていました。しかし、今回の発見により、もしそのノイズが「最終的な製品の品質(不良品率)」を予測するためのヒントになるのであれば、AIは自動的にその因果関係を見つけ出し、学習することがわかっています。これにより、複雑な環境下でも、より精度の高い異常検知システムを構築できるようになります。
データ収集コストの劇的な削減
前述した「ステアリング(操縦)」の技術は、データ収集のコスト削減に直結します。
機械設備のメンテナンスAIを作る際、「機械の内部温度」という本当に知りたいデータが、センサーを取り付けられないために直接収集できないケースがあります。しかし、内部温度と連動して変化する「排気音」や「外部の振動」といった収集しやすいデータをAIに強調して学習させることで、間接的に内部状態の予測精度を高めることが可能になります。
高価な特殊センサーを導入しなくても、既存の安価なデータ群を組み合わせることで高性能なAIを開発できる道が開かれたと言えます。
今後の実用化スケジュール
JEPAをベースにしたAIモデルは、すでに大手IT企業などからオープンソースとして公開され始めています。本研究で解明された「文脈を理解する賢い学習メカニズム」を応用した効率的なAI開発手法は、今後1〜3年以内に先進的なAI開発企業から実用化され、中小企業でも扱いやすいツールとして提供されていくと予想されます。
5. 中小企業が今からできる備え
このような次世代AIの波に乗り遅れないために、中小企業の経営者や実務担当者が今から準備できる具体的なアクションアイテムを3つ紹介します。
① 自社のデータ蓄積方針を見直す
「一見ランダムで役に立たなそうなデータ」を安易に捨てていないか、社内のデータ管理を見直してみてください。
例えば、店舗の売上データだけでなく、「その日の細かな天候の変化」「突発的な近隣のイベント」「SNSでの局所的なトレンド」といった不規則なデータ(ノイズ)も、売上や客足と連動している可能性があります。AIが文脈からヒントを見つけ出せるよう、今のうちから多様なデータをセットで蓄積しておくことが、将来の強力な競争力に繋がります。
② AIへの「データ入力の工夫」を意識する
すでに何らかのAIツール(需要予測や画像認識など)を業務に導入している場合、AIに予測させたい目標データ(例:来月の売上)だけを単体で入力するのではなく、その周囲の環境データ(例:競合の動向、業界全体の指標)もセットで与えてみてください。
「Predictive Closure(予測的閉包)」の考え方が示す通り、関連する情報を組み合わせてAIに与えることで、予測精度が飛躍的に向上する可能性があります。
③ 「自己教師あり学習」の動向を追う
次世代AIの大きな特徴は、人間が手作業で「これは犬」「これは猫」といった正解ラベルを付けなくても、データそのものからAIがパターンを学ぶ「自己教師あり学習」を活用している点です。
特に、監視カメラの映像や、製造ラインの録画データなど、大量の画像・動画データをすでに保有している企業は、この技術と非常に相性が良いです。正解データを作成する膨大なコスト(アノテーション費用)をかけずにAIを導入できる時代がすぐそこまで来ているため、関連するニュースやツールの動向を定期的にチェックしておくことをお勧めします。
6. 論文情報
本記事は、以下の論文による分析結果をもとに作成しています。より専門的な数式や実験データに関心がある方は、ぜひ原論文をご参照ください。
- 原題: Predictive Closure: A Set-Level Characterization of JEPA's Feature Selection
- 著者: Mosh Levy (Bar-Ilan University / University of California, Berkeley)、Aly Lidayan (University of California, Berkeley)、Yoav Goldberg (Bar-Ilan University / Allen Institute for AI (AI2))
- 公開日: 2026-10-19
- arXivリンク: https://arxiv.org/abs/2610.27364


