目次(10 章)
ラクにゃんとミナ
- 1CPUの速さの合図(クロック)は、速くするほど電気と熱が増える。2000年代の半ばに冷やしきれなくなり、それからはあまり速くならなくなった。
- 2増えた部品は、「流れ作業(パイプライン)」「先読み(分岐予測)」「手元の棚(キャッシュ)」に使われ、1回の合図でこなせる仕事を増やしてきた。合図が止まってからは、「台所を増やす(マルチコア)」が加わった。
- 3台所を増やしても、仕事の中に順番にしかできない部分があると、そこで詰まる。だから、同じ計算をたくさん一斉にするAIは、小さな台所が何千もあるGPUで動かす。
まずは、CPU の中を台所にたとえてみる
CPU は、パソコンやスマホの「頭脳」にあたる部品です。中を台所にたとえると、レシピを読んで指示を出す料理長(制御装置)、手を動かして計算する料理人(演算装置)、今使う材料をほんの少しだけ置いておくまな板(レジスタ)がいます。少し離れた所には、材料をたくさんしまっておく冷蔵庫(メインメモリ)があります。
1 つの命令は、料理長がレシピを 1 行取り出し、何をするかを読み解き、料理人が手を動かし、できたものをまな板に戻す、という順に進みます。CPU の言葉では「取り出す(フェッチ)→ 読み解く(デコード)→ 計算する(実行)→ 書き戻す」です。
このあとのお話では、たとえと実物の言葉の両方を使います。迷ったら、この一覧に戻ってきてください。
CPU のはじまり:部屋いっぱいの計算機から、指先のチップへ
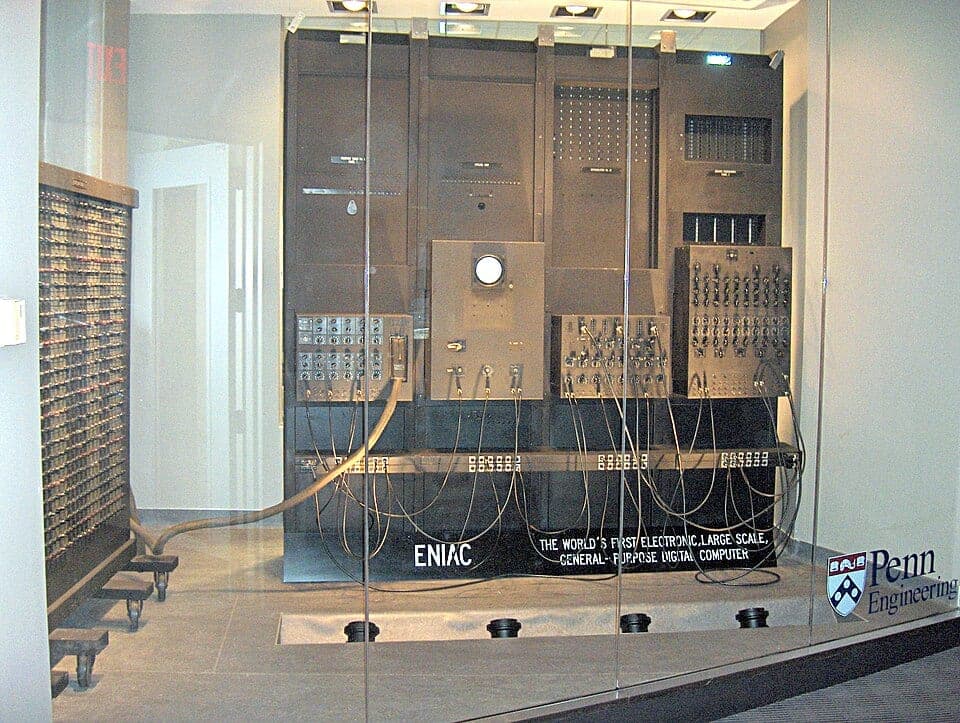
1940 年代の計算機 ENIAC(エニアック) は、部屋いっぱいの大きさでした。電気のスイッチの役目をしていたのは、電球のような形をした真空管。それが 1 万 7 千本以上も並んでいて、よく切れては取り替えていたそうです。
1947 年、アメリカのベル研究所で、真空管の代わりになる小さなスイッチ、トランジスタが生まれます。真空管よりずっと熱が少なく、壊れにくく、ずっと小さい部品でした。CPU の「部品の数」と言うときに数えているのは、このトランジスタです。
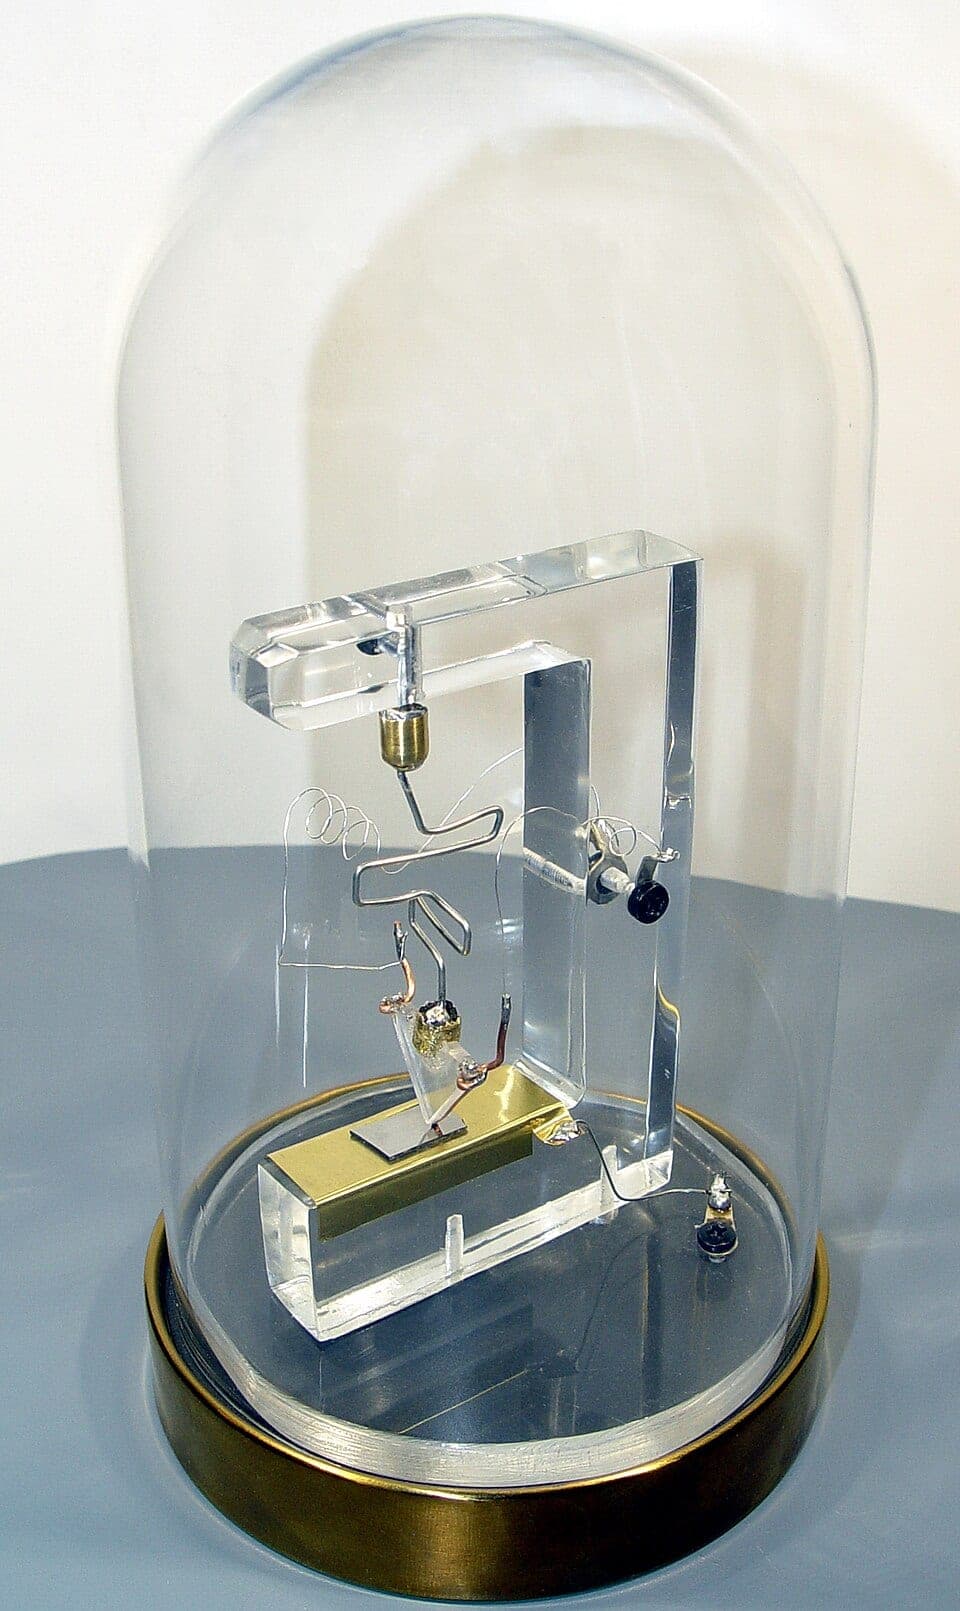
さらに 1958 年には、トランジスタなどの部品を 1 枚の板の上にまとめて作る集積回路(IC)が生まれました。そして 1971 年、CPU の働きをまるごと 1 つのチップに収めた「マイクロプロセッサー」が売り出されます。今、私たちが CPU と呼んでいるのは、このマイクロプロセッサーのことです。アメリカのインテルが、日本の計算機メーカー、ビジコンの電卓のために作った「4004」でした。
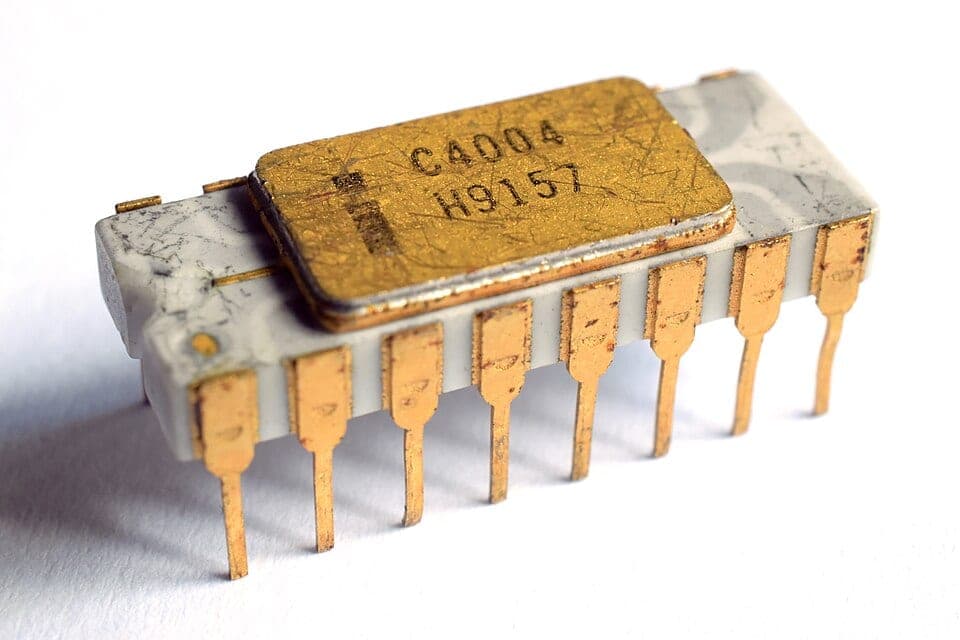
4004 の合図の速さは、1 秒間におよそ 74 万回(740 キロヘルツ)でした。今のパソコンの CPU は、1 秒間に数十億回(数ギガヘルツ)。合図はおよそ数千倍に速くなりましたが、部品の数の増え方に比べると、ずっと小さな伸びです。
工夫① 流れ作業:前の命令を待たずに、次を始める
洗濯物が 3 回分あるとき、1 回分を「洗う → 干す → たたむ」と全部終えてから、次の 1 回分を洗い始めると、とても時間がかかります。でも、1 回目を干している間に、2 回目を洗い始めればどうでしょう。洗濯機も、物干しも、たたむ人も、空いている時間がなくなります。
CPU の命令も同じです。1 つ目の命令を「読み解いている」間に、2 つ目の命令を「取り出し」、3 つ目の命令を……と、段を少しずつずらして重ねることで、1 つの命令にかかる時間は同じでも、終わる命令の数が増えます。
段ごとに別々の命令を受け持たせるには、段と段のあいだで、途中の結果をしっかり預かっておく係が要ります。この係も、トランジスタでできています。増えた部品の使い道の 1 つ目が、これです。

段を細かく分けると、1 つの段の仕事が軽くなります。仕事が軽ければ、拍子を速く打っても間に合います。洗濯なら、「洗う・すすぐ・脱水・干す・たたむ」と分けるほど、次の洗濯物を早く入れられる、というわけです。
2000 年代のはじめには、段を 30 ほどにまで細かく分けて、合図をぐんと速くした CPU もありました。ところが、段を増やすほど困ることが 2 つ出てきます。1 つは、合図を速くするほど電気を使い、熱が出ること。もう 1 つは、流れが止まったときの損が大きくなることです。どんなときに流れが止まるのか。それが、次の工夫につながります。
工夫② 先読み:分かれ道の先を、予想して進む
プログラムの中には、「もし〜なら、こちら。そうでなければ、あちら」という分かれ道がたくさんあります。CPU の言葉では分岐と呼びます。
流れ作業では、命令を先へ先へと取り出しておきたいのに、分かれ道では「どちらへ進むか」が、前の計算が終わるまで決まりません。待っていると、流れが止まってしまいます。
CPU は、「この分かれ道では、前はいつもこちらへ進んだ」という記録をもとに、進む先を予想して、その先の命令を先に取り出して進めておきます。当たれば、そのまま止まらずに進めます。外れたら、先に進めておいた分を捨てて、正しい道からやり直します。
今の CPU は、分かれ道ごとに「前はどちらへ進んだか」「その前はどうだったか」を細かく記録して、ほとんどの分かれ道を当てています。同じ分かれ道を何度も通るプログラムが多いので、記録がよく役に立つのです。この記録をしまっておく帳面も、トランジスタでできています。増えた部品の使い道の 2 つ目です。
工夫③ 手元の棚:冷蔵庫まで取りに行かない
CPU の計算はどんどん速くなりましたが、冷蔵庫にあたるメインメモリから材料を取ってくる速さは、それほど速くなりませんでした。料理人の手は速いのに、冷蔵庫まで材料を取りに行くたびに、長く待たされてしまいます。この差は「メモリの壁」と呼ばれています。
そこで CPU は、料理人のすぐそばに、小さくて速い棚を何段も置くようになりました。いちばん近くの小さな棚が L1、その次が L2、少し大きな L3 です。欲しい材料が棚で見つかれば「ヒット」、見つからずに冷蔵庫まで取りに行けば「ミス」と呼びます。
どれくらい差があるのか、人の時間に直してみましょう。いちばん近い棚(L1)から取るのに 1 秒かかるとすると、冷蔵庫まで取りに行くと、およそ 1 分半から 2 分。ほんの少しの棚が、どれだけ助けになるかが分かります。
1 つは、「さっき使ったものは、またすぐ使う」。もう 1 つは、「使ったものの隣にあるものも、すぐ使う」。だから CPU は、冷蔵庫から材料を取ってくるとき、頼んだ 1 つだけでなく、隣に並んでいる材料もまとめて持ってきて、棚に置いておきます。
プログラムの多くは、同じ所を何度もくり返し、順番に並んだデータを前から読んでいきます。だから、この 2 つの手がかりがよく当たり、小さな棚でも、ほとんどの材料が棚で見つかるのです。反対に、あちこちに散らばったデータを飛び飛びに読む仕事では、棚がなかなか当たらず、冷蔵庫まで何度も走ることになります。
写真を見ると、真ん中の大きな区切りが、L3 の棚です。左右には、台所にあたる部分が並んでいます。チップの中で、棚がどれだけ広い場所を使っているかが分かります。
合図が速くならなくなった理由:熱の壁
クロックは、CPU の中のみんなが動きをそろえるための拍子です。拍子を速くすると、トランジスタのスイッチが、1 秒間にそれだけ多く入ったり切れたりします。スイッチが切り替わるたびに電気を使い、その電気は熱に変わります。
部品を小さくすると、スイッチは小さな力で、すばやく切り替わるようになります。部品と部品のあいだも近くなるので、電気の信号が届くまでの時間も短くなります。小さくするほど、拍子を速く打てたのです。
しかも長いあいだ、部品を小さくすると、使う電気も一緒に減ってくれました。同じ広さのチップに部品を何倍も詰め込み、拍子を速くしても、チップ全体の電気はあまり増えなかったのです。だから、部品を小さくしながら、拍子をどんどん速くできました。ところが 2000 年代の半ばごろ、部品をさらに小さくしても、電気が思うように減らなくなりました。
水道の蛇口を、きっちり閉めても、ぽたぽたと水が漏れるようなものです。漏れた電気は、仕事をしていなくても熱に変わります。しかも、漏れを減らすために電気の勢い(電圧)を下げると、今度はスイッチがきちんと入らなくなります。部品を小さくするたびに、電気が減ってくれる、という流れが、ここで止まりました。2004 年には、合図をさらに速くする予定だった CPU の開発が、熱の問題で取りやめになっています。
小さな場所に熱がぎゅっと集まると、外側をいくら冷やしても、チップの中から熱を外へ逃がす速さが追いつきません。しかも、ノートパソコンやスマホには、大きなファンを積む場所がありません。拍子を速くしようとすると、チップが熱くなりすぎて、冷やしきれなくなったのです。これを「熱の壁」と呼びます。
料理長・料理人・まな板・手元の棚の 1 組を、1 つの台所と考えてください。この台所 1 つ分を コア と呼びます。1 つのチップの中にコアを何組も入れるのがマルチコアです。台所が 2 つならデュアルコア、4 つならクアッドコア。どの台所も、大きな冷蔵庫(メインメモリ)は一緒に使います。棚の章で見たチップの写真にも、台所が 8 つ並んでいましたね。
最初のグラフで、合図の線が寝たころから、コアの数の線が立ち上がっています。合図が止まってから加わった工夫が、この「台所を増やす」なのです。
パソコンの説明で「8 コア 16 スレッド」のような書き方を見たことがあるかもしれません。スレッドは、台所で同時に進められる料理の数です。料理人が冷蔵庫に材料を取りに行っている待ち時間や、手の空いた所で、もう 1 つの料理を進める。そうすると、1 つの台所で 2 つの料理を同時に進められます。棚の章で見た「冷蔵庫までの待ち時間」を、むだにしない工夫です。
スマホの CPU の多くは、力の強い大きなコアと、電気をあまり使わない小さなコアを、一緒に積んでいます。メールを受け取るような軽い仕事は小さなコアにまかせ、ゲームや、動画を作って保存するような重い仕事のときだけ、大きなコアを動かします。大きなファンを積めないスマホで、速さと電池のもちを両立させる工夫です。
台所を増やしても、速くならないとき
たとえば、カレーを作るとき。野菜を切る、肉を炒める、といった下ごしらえは、台所を増やせば手分けできます。でも、「全部を 1 つの鍋に入れて煮込む」ところは、台所を増やしても速くなりません。
仕事の中に「順番にしかできない部分」が少しでもあると、台所をいくら増やしても、その部分で詰まってしまいます。この考え方は、1967 年に、IBM の計算機の設計者だったジーン・アムダールが示したもので、アムダールの法則と呼ばれています。
計算してみましょう。10 分かかる仕事のうち、9 分は手分けでき、1 分は順番にしかできないとします。
台所を 2 つにすると、手分けできる 9 分が 4.5 分になり、全部で 5.5 分。台所を 10 個にすると、9 分が 0.9 分になり、全部で 1.9 分です。でも、どれだけ台所を増やしても、順番にしかできない 1 分は残ります。だから、10 分の仕事は 1 分より短くならず、速くなるのは 10 倍に近づくところまで。台所を 8 つにしても、速さはおよそ 4.7 倍です。半分しか手分けできない仕事なら、どれだけ増やしても 2 倍に届きません。
GPU と AI:小さな台所が何千も
画面の絵は、たくさんの小さな点(画素)でできています。それぞれの点の色を計算する仕事は、点ごとにばらばらに進められます。そこで生まれたのが、小さな台所を何千も並べて、同じ計算を一斉にする GPU(グラフィックス・プロセッシング・ユニット)です。
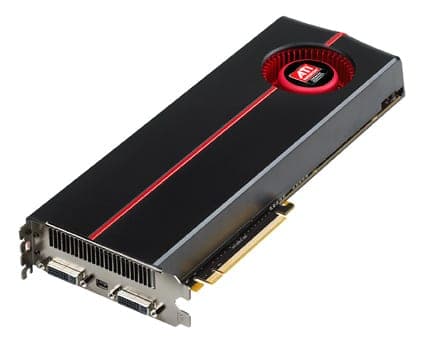
GPU の小さな台所は、何十かずつの組になって、同じ動きをそろえて進みます。その代わり、分かれ道は苦手です。組の中でそれぞれが別の道へ進もうとすると、そろって動けず、片方の道を進む間、もう片方は待つことになるからです。分かれ道の多いふだんの仕事は、先読みの上手な CPU に向いています。
AI の中で行われている計算の多くは、「たくさんの数を掛けて、足す」ことのくり返しです。分かれ道はほとんどなく、しかも、その計算の多くは、お互いの答えを待たずに、一斉に進められます。まさに、GPU が得意な仕事です。
2012 年には、画像を見分ける AI の大会で、GPU を 2 枚使って学ばせた AI が、それまでの方法を大きく上回る成績を出しました。このころから、AI を GPU で動かすことが当たり前になっていきます。
まとめ:CPU の数字の読み方
- クロック(GHz):合図の速さ。2000 年代の半ばからは大きく変わらず、同じ GHz でも 1 回の合図でこなせる仕事の量がちがうので、これだけで速さは比べられない
- コアの数とスレッドの数:コアは台所の数、スレッドは同時に進められる料理の数。手分けできる仕事(動画を作って保存する、たくさんのアプリを同時に使うなど)ほど効く
- キャッシュ:手元の棚の大きさ。冷蔵庫まで取りに行く回数が減るほど、速さが出やすい
そして、数字には表れにくい「流れ作業」や「先読み」の上手さも、CPU の速さを左右しています。数字は目安として、使う仕事に合わせて選ぶのがおすすめです。
参考サイトと出典
- Karl Rupp, Microprocessor Trend Data(グラフの元データ・CC BY 4.0)
- ENIAC(Wikipedia 英語版)
- History of the transistor(Wikipedia 英語版)
- Invention of the integrated circuit(Wikipedia 英語版)
- The Story of the Intel 4004(Intel)
- Intel 4004(Wikipedia 英語版)
- Instruction pipelining(Wikipedia 英語版)
- Branch predictor(Wikipedia 英語版)
- CPU cache(Wikipedia 英語版)
- Dennard scaling(Wikipedia 英語版)
- Tejas and Jayhawk(Wikipedia 英語版)
- Multi-core processor(Wikipedia 英語版)
- Hyper-threading(Wikipedia 英語版)
- ARM big.LITTLE(Wikipedia 英語版)
- Amdahl's law(Wikipedia 英語版)
- Graphics processing unit(Wikipedia 英語版)
- AlexNet(Wikipedia 英語版)
